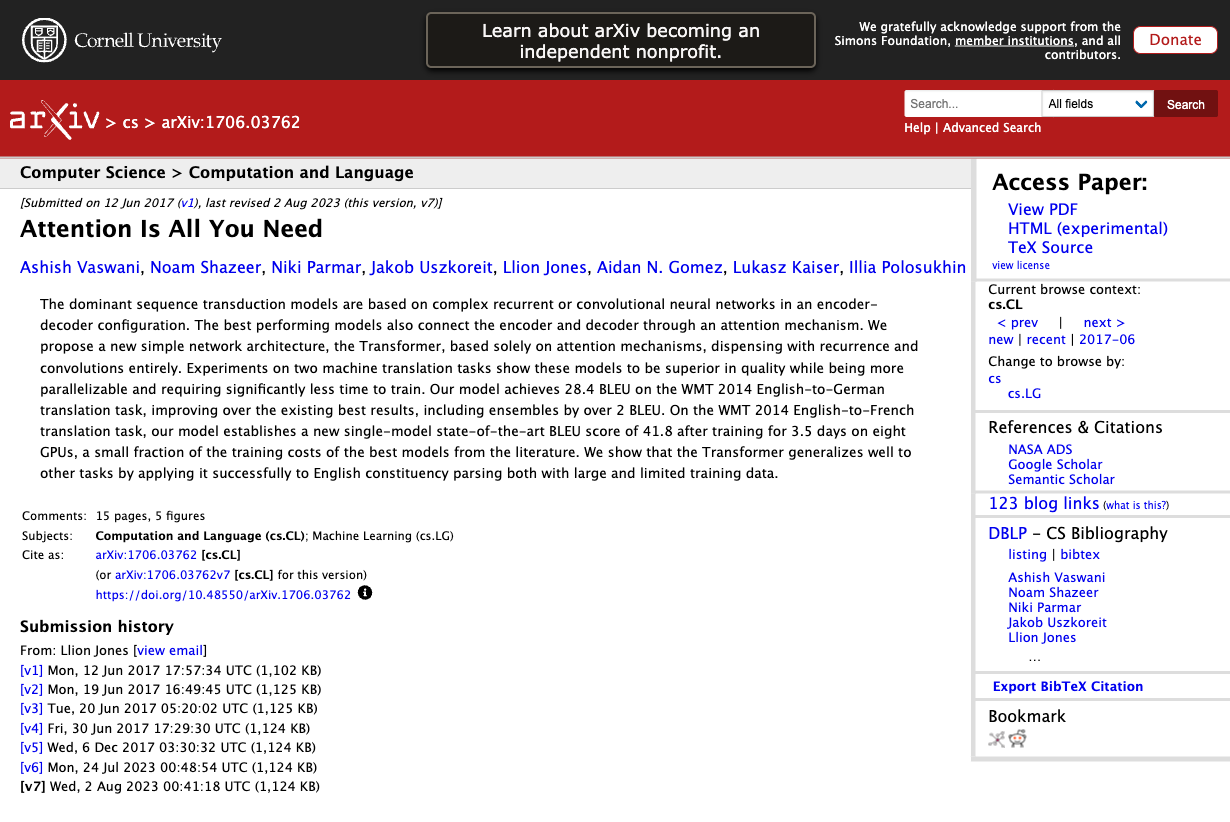
2017年にGoogleが発表した論文「Attention Is All You Need」が起点。従来の逐次処理(RNN)を捨て、全単語を同時に処理する並列構造を実現した。
Self-Attention
入力の各トークンが、他のすべてのトークンとの関連度を計算する。「彼は医師として働いている」の「彼」が「医師」と強く結びつくことを、モデルが自動的に学ぶ。
2026.04 / Tech Explainer Series
大規模言語モデルはどう動いているのか。
その上で Claude Code は何をしているのか。
大規模言語モデル(LLM)の本質は驚くほどシンプルです。「ここまでのテキストが与えられたとき、次に来る単語は何か」を予測する関数。この単純な仕組みを、インターネット上のテキストで大規模に訓練した結果、文章生成・翻訳・推論・コード生成など幅広い能力が創発的に生まれました。
mat: 62% / floor: 18% / roof: 4% / ...
この確率分布を1語ずつ繰り返し適用することで、長い文章が生成される。これを自己回帰生成と呼ぶ。
これが Transformer の Attention 機構。LLM の能力の源泉はここにある。
2017年にGoogleが発表した論文「Attention Is All You Need」が起点。従来の逐次処理(RNN)を捨て、全単語を同時に処理する並列構造を実現した。
入力の各トークンが、他のすべてのトークンとの関連度を計算する。「彼は医師として働いている」の「彼」が「医師」と強く結びつくことを、モデルが自動的に学ぶ。
LLM をエージェントに変えるもの
Claude(LLM)単体はテキストを生成する関数にすぎない。Claude Code はそこに「目」と「手」を与える。ファイルを読み、コードを書き、ターミナルで実行し、結果を見て修正する。このループを自律的に回す仕組みを「エージェントハーネス」と呼ぶ。
Claude Code の動作原理は「考える→行動する→観察する」のループ。人間がターミナルでコードを書いて実行して結果を確認する、あの作業を自動化したもの。
1タスクで数十回このループが回る
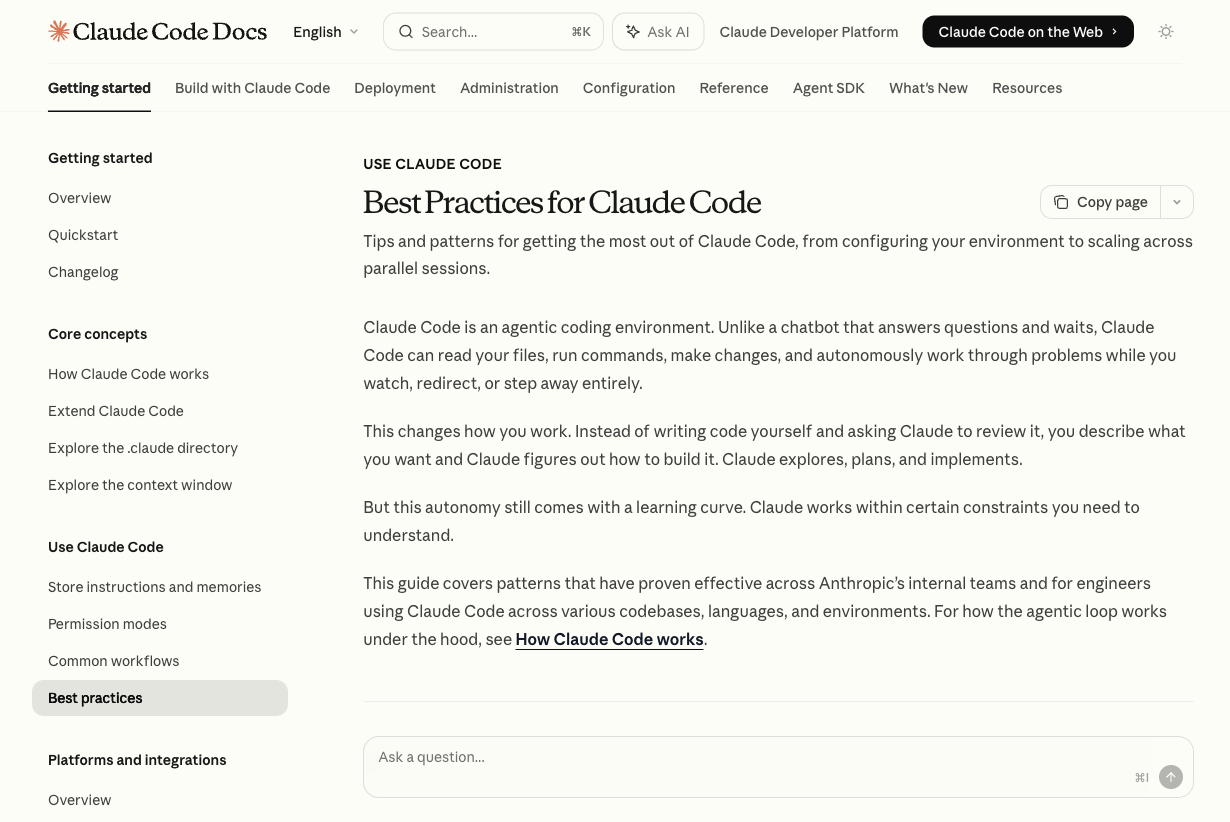
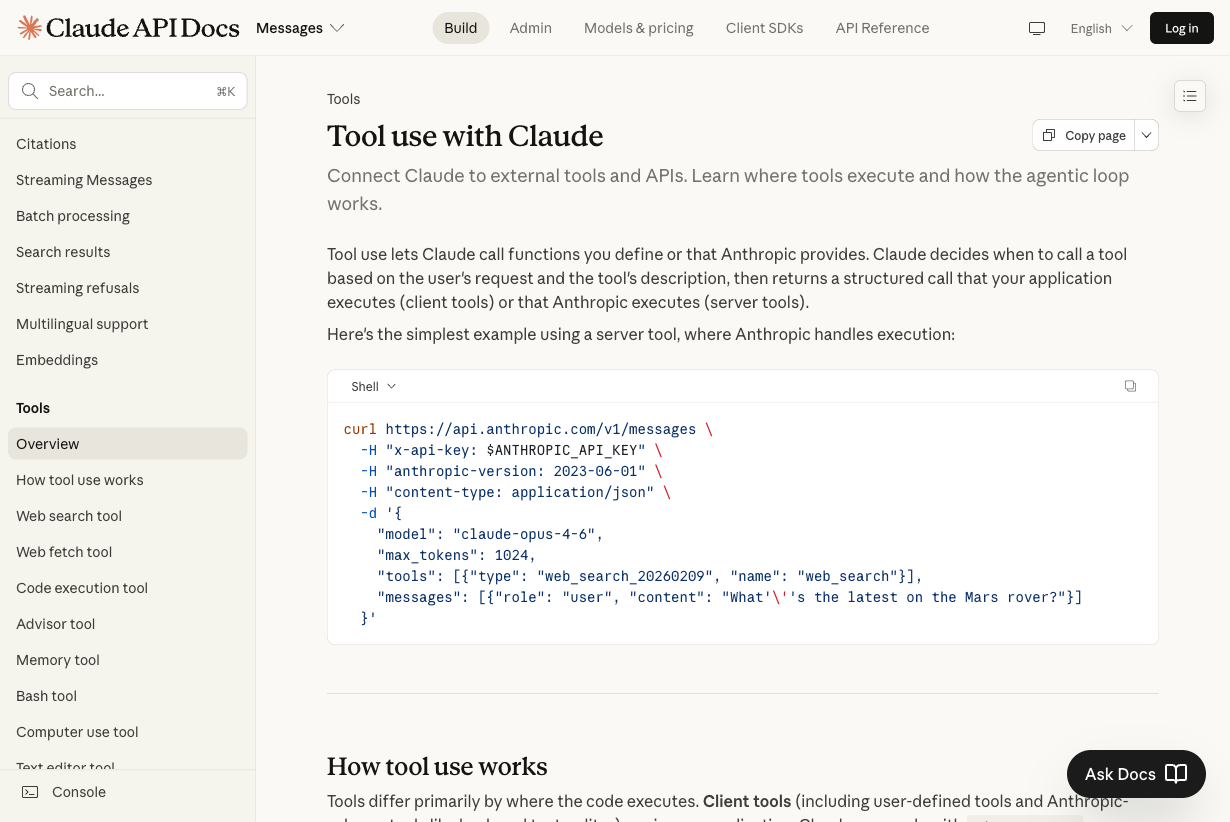
LLM自体にはファイルを読む能力もコマンドを実行する能力もない。Claude Code がツールとして提供し、LLMが「どのツールをどの引数で呼ぶか」をテキストとして出力する。
この2つが合わさったとき、AI は初めて「仕事」ができるようになる。
岡本賢 / Tech Explainer Series